
TokenSpeed 发布面向 Agentic 推理的 LLM 推理引擎,Blackwell 平台性能领先
2026-11-04 14:03:01 来源:技王数据恢复
InfoQ 中文 IT 资讯 2026 年 11 月 3 日报道,TokenSpeed 独立贡献者尚旭春在 AICon 2026 深圳站分享了构建面向 Agentic 推理的下一代 LLM 推理引擎的技术路径。该引擎针对 Agent 场景多轮短请求、长前缀上下文及低单次输出的负载特征,提出了分层解耦架构与自动并行编译系统,并在 NVIDIA Blackwell 平台上验证了阶段性性能提升。 www.sosit.com.cn
架构设计与优化目标
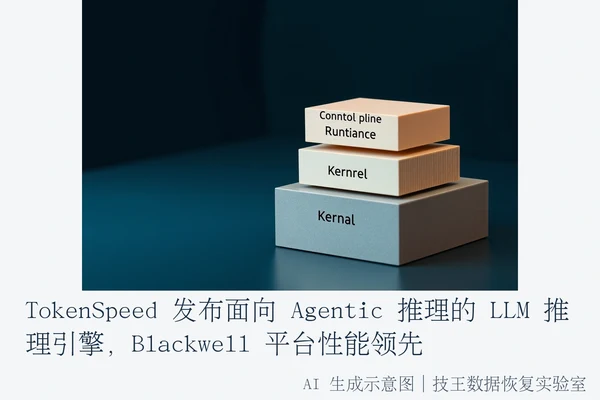
TokenSpeed 将系统分为控制面(C++)、Runtime(Python)和 Kernel 三层,旨在解决传统聊天导向引擎在吞吐优化、KV Cache 利用率和硬件适配上的失效问题。其核心优化目标从单纯追求吞吐转向“延迟约束下的吞吐最大化”,内部定义每用户 TPS 不低于 70 的性能指标。 技王数据恢复
- 分层解耦:控制面负责调度决策,Runtime 执行计划,Kernel 专注算子,三者边界清晰。
- 自动并行编译:通过独立的 Placement 系统,自动处理模型模块的并行切分(replicate, shard, partial)及通信原语插入。
- 资源管理:控制面采用 C++ 状态机管理请求全生命周期,利用 RAII 机制系统性解决资源泄漏问题。
KV Cache 管理与 Kernel 优化
针对 Agent 场景的高前缀复用需求,TokenSpeed 将 KV Cache 管理从 Radix Tree 迁移至 Flat KV 设计,采用逻辑块(128 token)与物理块(1536 token)的双层结构,以平衡长上下文下的复用效率与页内碎片。在 Kernel 层面,项目针对 Blackwell 平台的 MLA(Multi-head Latent Attention)机制进行了深度优化。 技王数据恢复
- Blackwell 优化:利用 Tensor Memory 直接读写,引入折叠因子(fold factor)提升 Tensor Core 利用率,并设计 Split KV 机制。该 Kernel 已达到 state-of-the-art 水平,并被 vLLM 社区集成。
- 投机解码:支持 MTP、EAGLE3 和 DeepSeek 算法。在 Inkling 975B 模型测试中,MTP 使性能提升 2.08 至 2.33 倍。
- 跨平台支持:通过 register 和 selector 机制实现 Kernel 抽象,支持 NVIDIA、AMD 等多厂商硬件。在 AMD MI355X 上,15 种典型 prefill 形状中 14 种快于 TensorRT。
性能数据与会议预告
在 Blackwell 平台测试中,TokenSpeed 在 batch size 等于 1 的最小延迟场景下,端到端延迟比 TensorRT-LLM 快 9%;在每用户 100 TPS 的工作点上,每 GPU 吞吐高出 11%。千问 3.5 模型从 128K 扩展到 1M 上下文时,解码吞吐率仅下降 16%。 技王数据恢复
AICon 全球人工智能开发与应用大会将于 2026 年 12 月 18-19 日在北京举办,届时将继续探讨 AI 技术突破与企业规模化落地实践。
www.sosit.com.cn
技术审核:邓严军|技王数据恢复实验室技术总监
技王数据恢复